


宇树发布通用人形机器人基础模型 七项具身推理评测领先


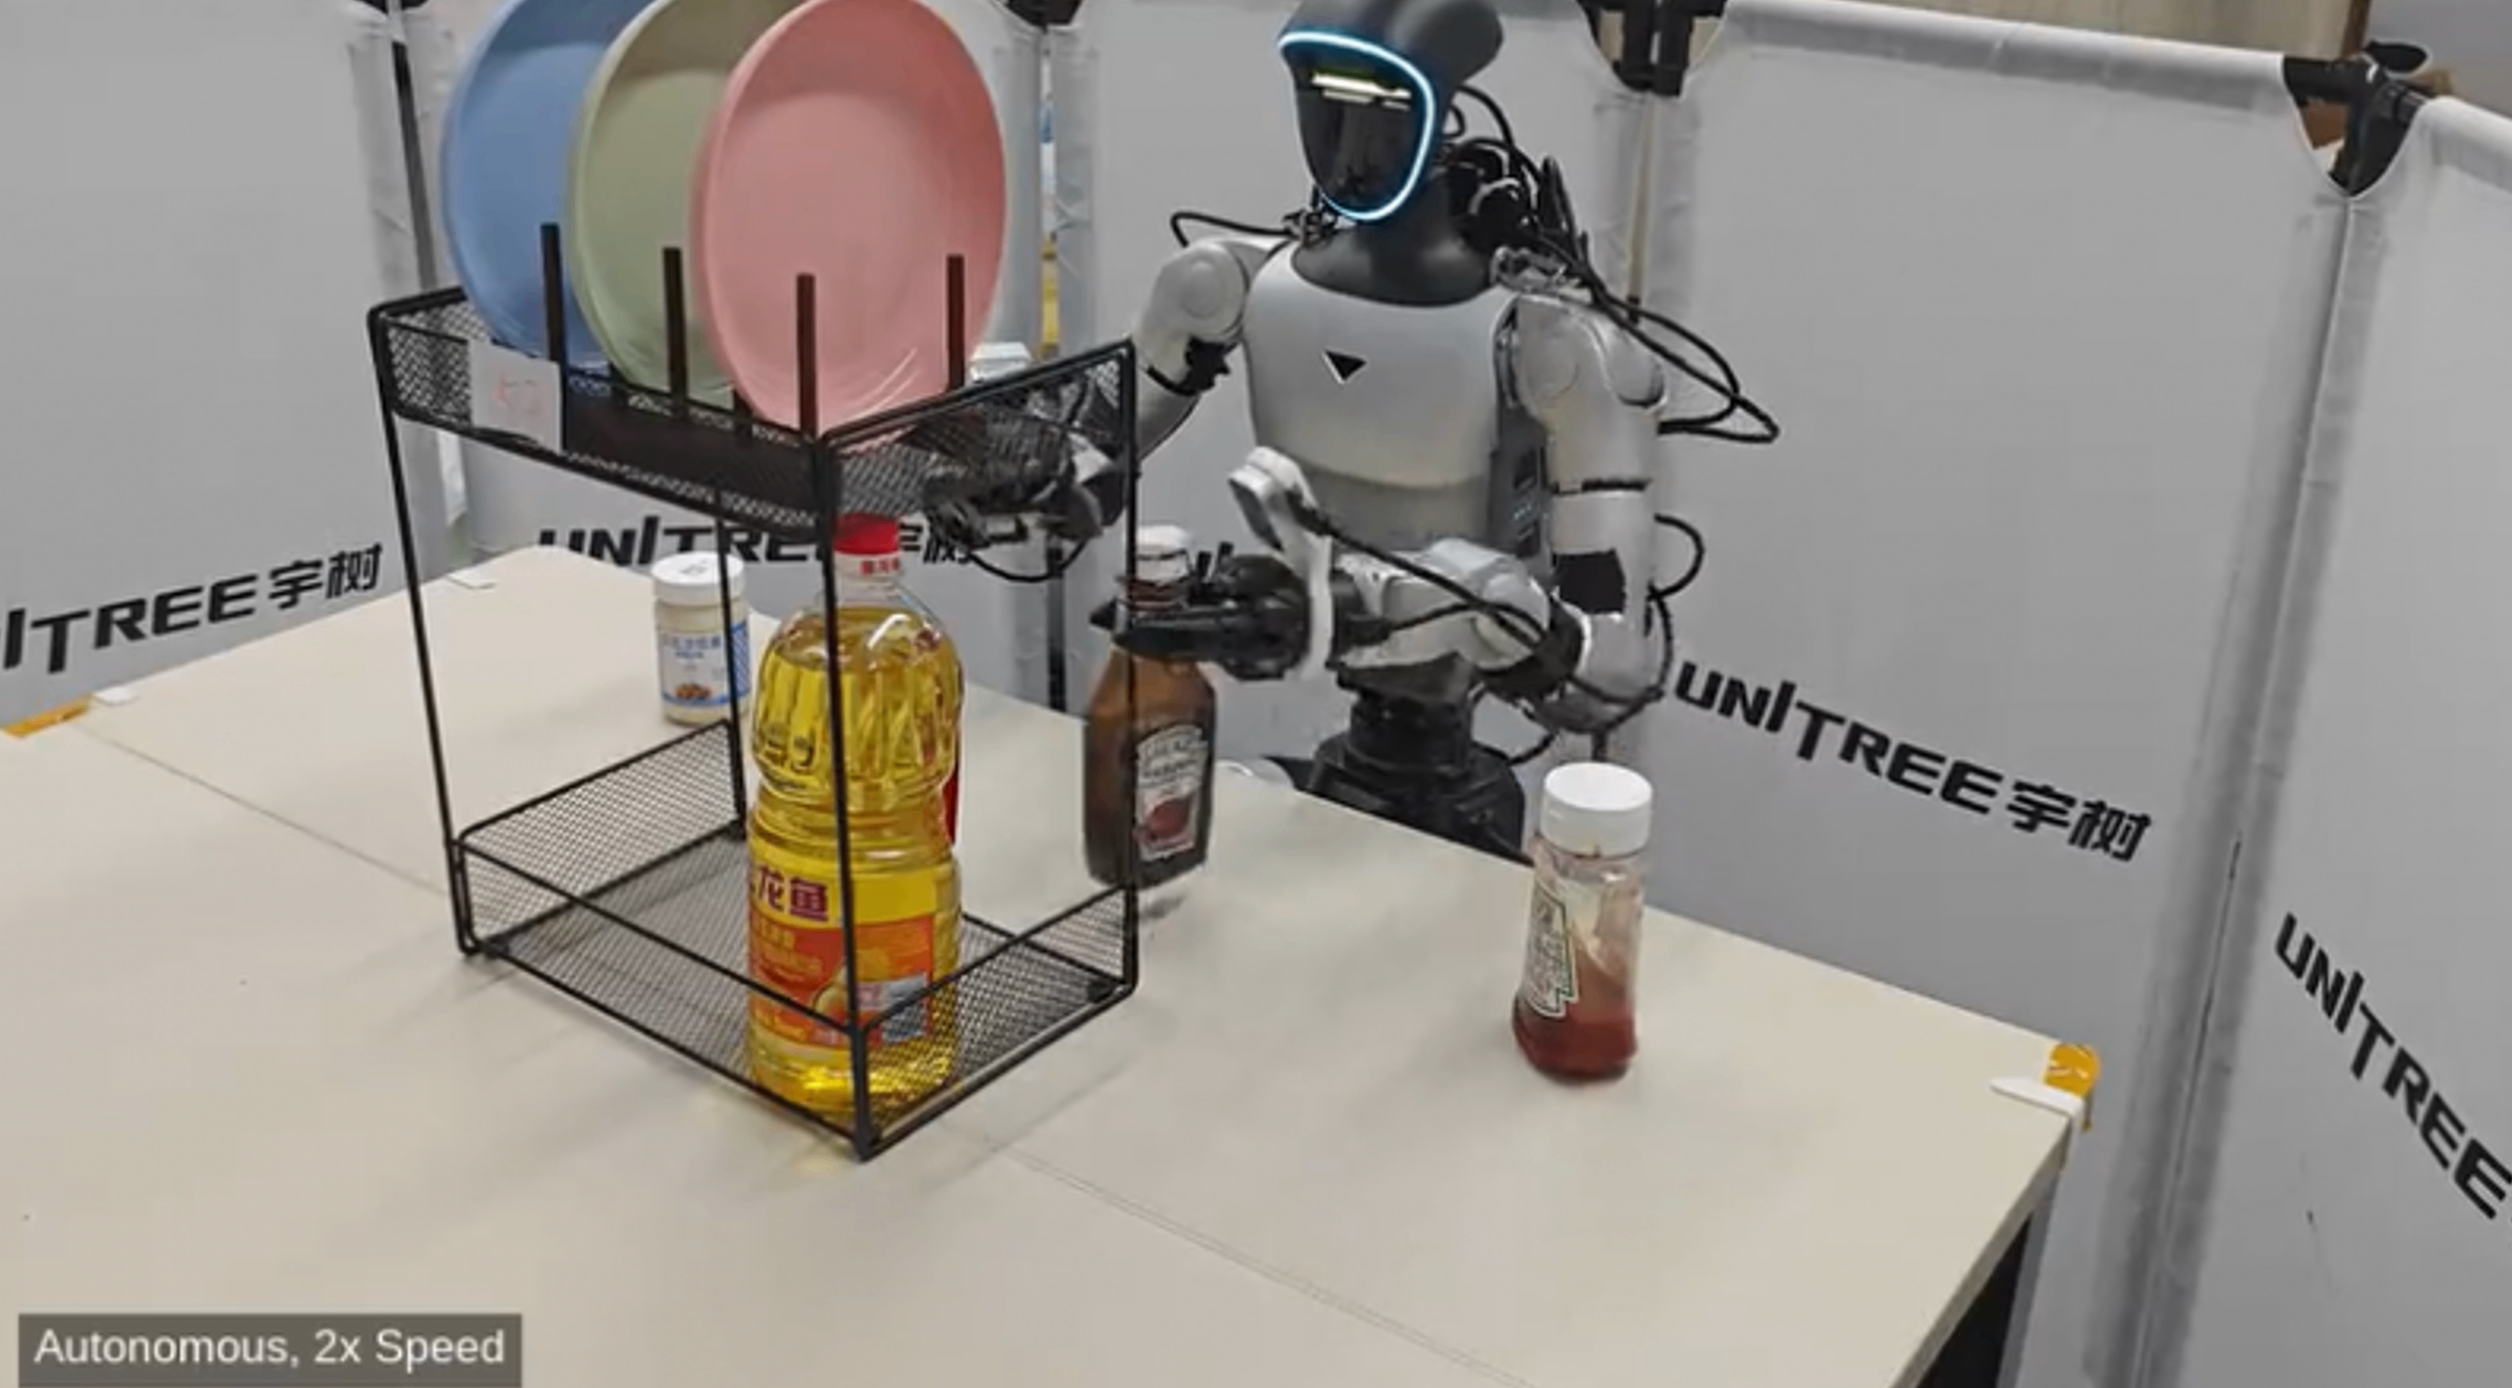
宇树科技近日发布通用人形机器人基础模型UnifoLM-WLA-1.0,WLA代表世界、语言、动作三个维度,这套模型的特点在于用单一模型同时承担感知理解与动作生成。
在16项多模态感知与理解基准测试中,其具身推理底座UnifoLM-ER-1-4B有7项领先参评的开源模型,整体表现与多款闭源模型处于相近水平。项目目前已开放部分模型权重和数据,其余模型、代码与数据集列入后续开放计划。
具身推理底座基于Qwen3-VL-4B构建,训练使用了超过500万条具身推理样本。领先的7项基准集中在空间理解与推理方向,包括RefSpatial-Bench、Where2Place、PixMo-Point、BLINK、EmbSpatial、RoboSpatial和VSR,覆盖物体指代、摆放位置、视觉指向和空间关系等维度。
与闭源模型的对比中,UnifoLM-ER-1-4B在Where2Place上得82.0分,高于GPT-6 Astra的69.0分,EmbSpatial一项得88.9分,同样高于后者的83.3分。这类空间理解能力决定机器人能否识别目标、理解物体位置与交互条件,并为后续动作生成提供依据。
执行层面,UnifoLM-WLA-1.0覆盖64项任务,其中全身操作10项、桌面操作54项,同一个模型需要协调机械臂、末端执行器与下肢动作。测试与演示中的任务包括叠毛巾、收纳餐具、铺床、倒垃圾、把衣服放进洗衣机等家庭场景动作,模型经过了约2500小时真机训练。
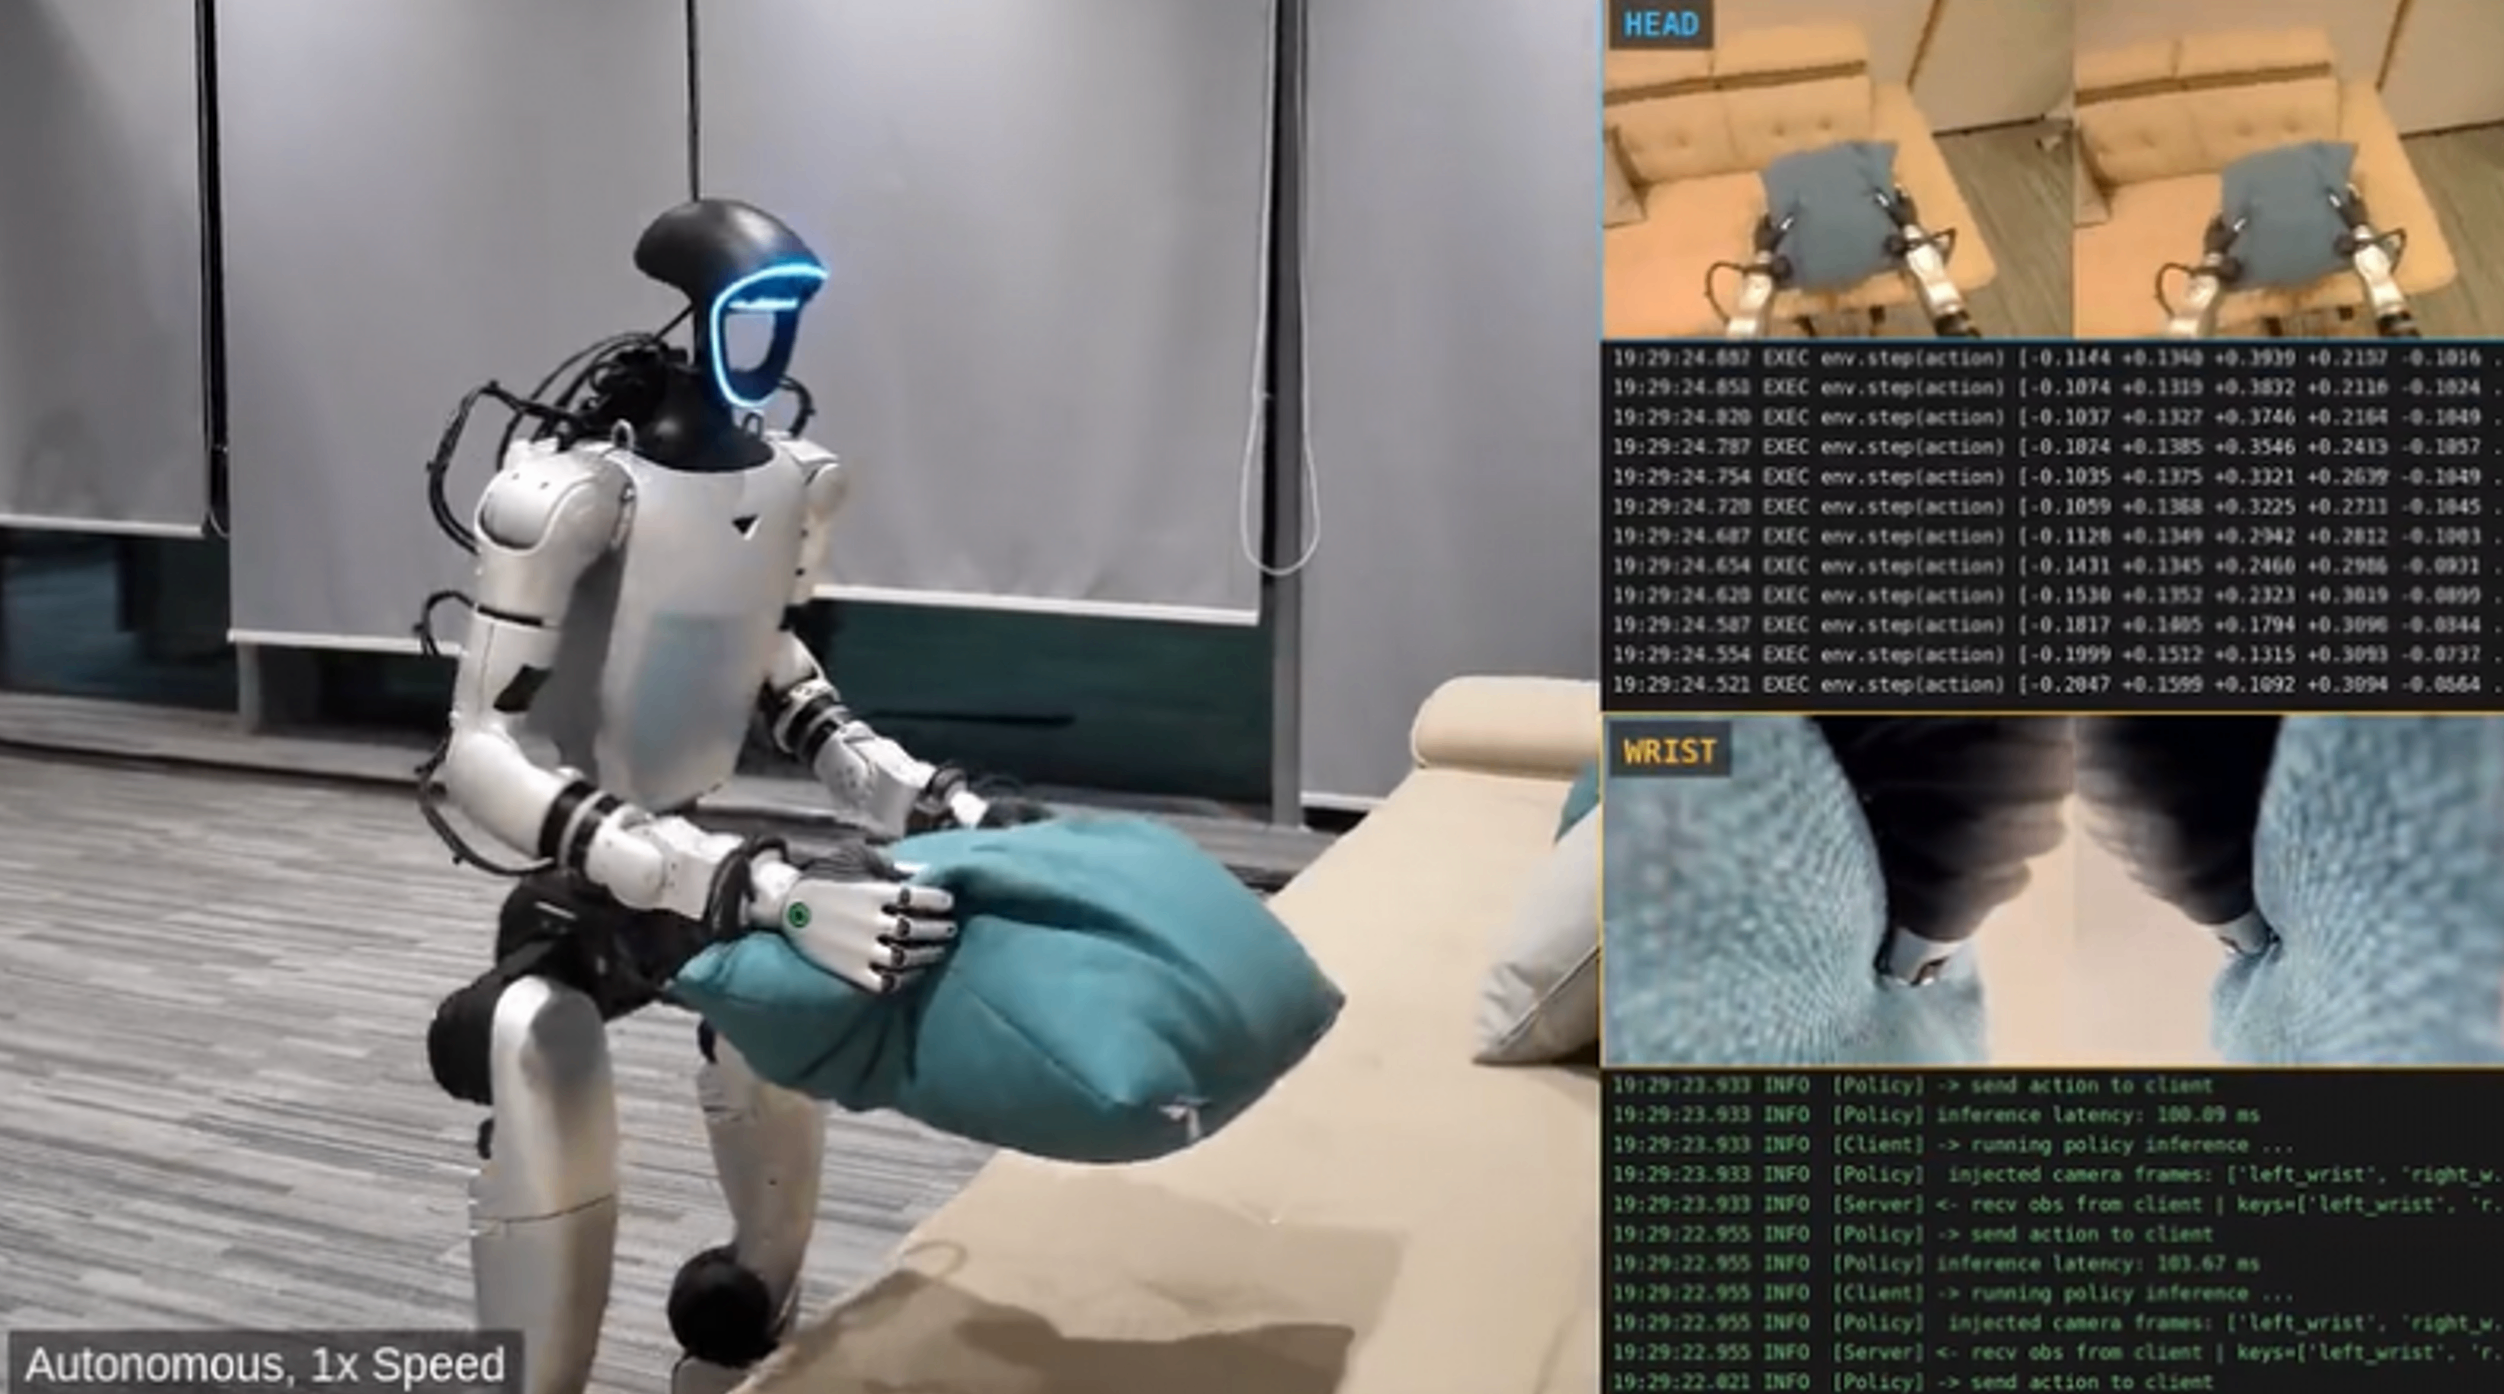
单模型覆盖多任务的价值在于替代以往为每个任务单独开发策略的做法。此前的机器人演示大多围绕单一任务、单一场景高度定制,换个环境便难以复用。宇树把桌面操作与全身操作收进一套权重,先理解环境再生成动作,评测指向的正是泛化能力而非单项动作的完成度。
人形机器人行业的竞争重心正在从本体性能延伸到基础模型与开发接口。
模型权重与数据集的开放节奏,决定开发者能否低成本试用与二次开发,也直接影响适配团队能否聚拢到同一套接口周围。宇树把部分权重先行开放、其余列入后续计划,与其整机产品的推进节奏形成软硬件两条线的配合。宇树同步宣布将开放模型、代码和数据集,其整机产品与基础模型同步推进,这家以四足机器人和人形机器人整机起家的公司,在具身智能产业链上的角色正从设备供应商向模型与生态方扩展。



评论 0