


国家数据局召开具身智能座谈会,高质量数据集进入决赛圈


机器人赛道正在迎来一场轰轰烈烈的“数据大考”。
第一财经援引IT桔子数据显示,2026年上半年,国内具身智能赛道融资322笔,总额达到935亿元,同比增长约5倍,其中超百亿流向数据采集赛道。资本疯狂加码背后,是行业绕不开的"数据荒",谁先抢占高质量数据的供给端,谁就更容易掌握行业话语权,也就更容易锁定下游客户。
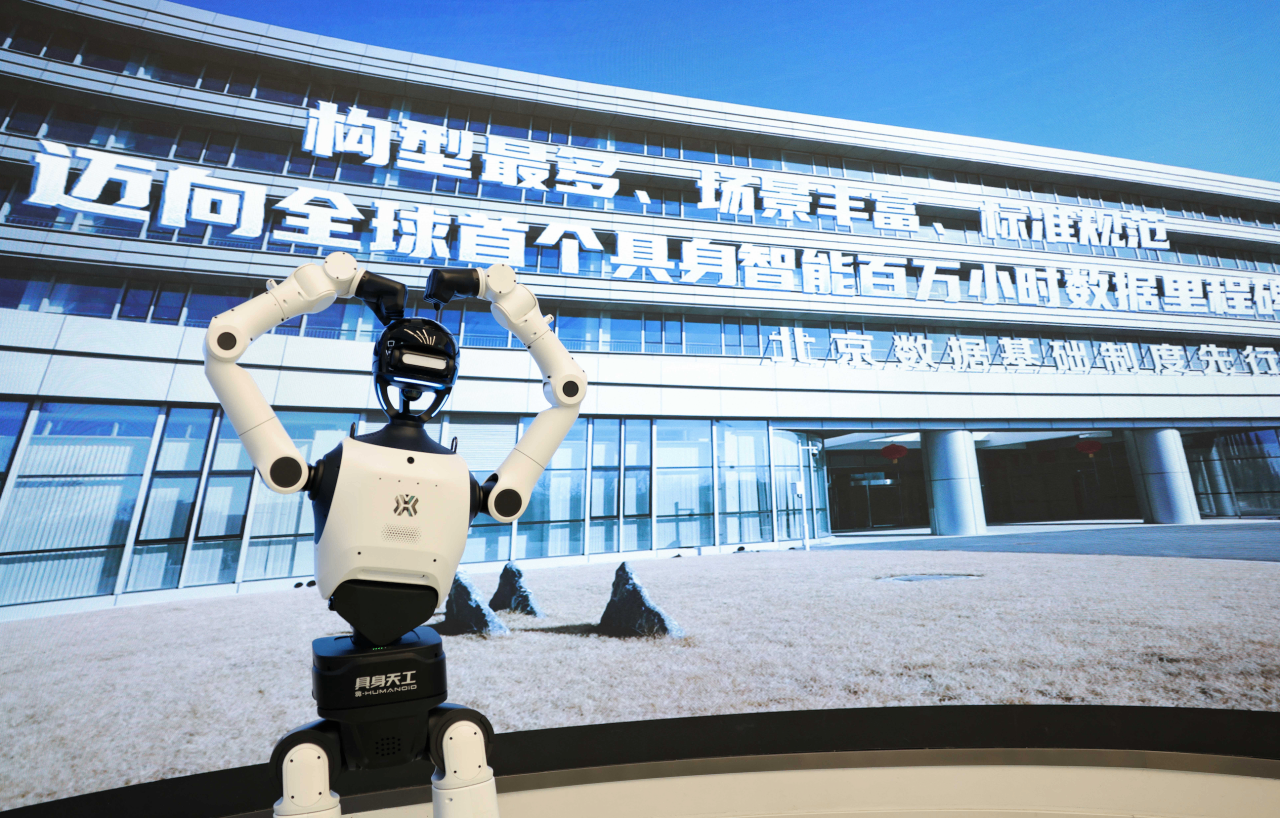
9月10日,国家数据局召开具身智能专题座谈会,会议提出,将适时推动具身智能数据领域标准体系建设,积极支持企业加大数据投入,更好赋能具身智能发展。
市场认为,国家数据局在当前召开具身智能相关会议,为当下火热的具身智能赛道按下“加速键”,这些举措将有力补齐物理AI产业的数据短板。
数据交易网调研发现,目前已有共识——真实物理交互数据,就是具身智能发展的核心引擎。
亮数据中国区负责人对数据交易网表示,“具身智能是人工智能从虚拟数字世界走向真实物理世界的核心载体,天生高度依赖数据驱动。无论是人形机器人、工业物理AI,还是各类服务机器人,都离不开大规模、多样化、高真实度、标准化的高质量数据集做支撑。”
回看AI行业的发展,通用文本大模型的竞争,已经步入存量博弈阶段。各家在模型参数、算力、基础算法上的差距不断缩小,单纯靠文本大模型想要实现弯道超车,难度越来越大。
于是,能够让AI“感知世界、落地实操、自主决策”的具身智能,成为全行业公认的下一代AI革命核心,也是人工智能产业化落地的黄金赛道。
和传统语言大模型不一样,具身智能的终极目标,是打通“感知—认知—决策—执行”的物理闭环,让AI不再只会聊天思考,更能上手干活、适应复杂环境、包容操作错误。
过往很多AI研发团队陷入误区,盲目上马海量原始数据,却忽略了数据的真实性、结构化精度与场景适配性。随着具身智能产业逐步走向规范化,仅包含理想成功案例的原始数据,已经无法支撑高精度物理AI模型的训练迭代。
市场上已经有不少企业嗅到趋势,开始布局具身智能数据基建。
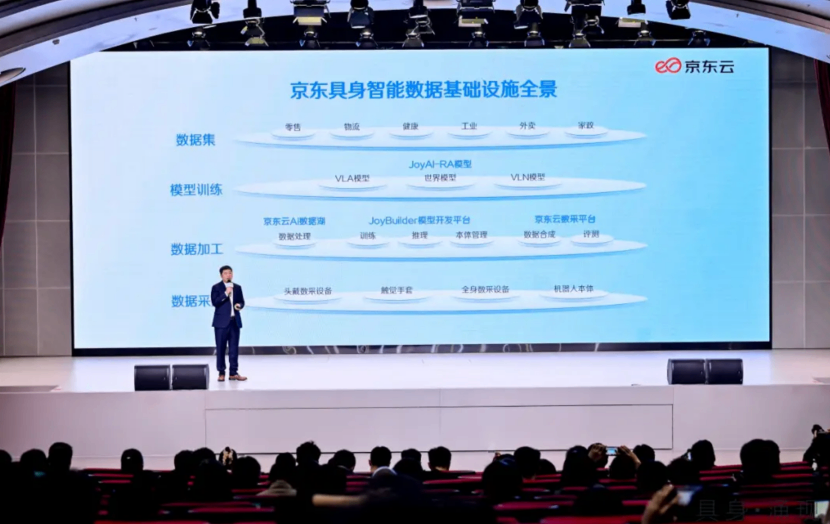
早在今年4月,京东发布首个覆盖“采集、存储、标注、训练、评估、仿真、测试”全流程的具身智能数据基础设施,并同步推出自研超高清采集终端、具身大模型及数据交易平台。
今年9月初,智元机器人开源的AgiBotWorld第三期数据集,首批开放11430条真实交互轨迹,覆盖工业、家居等真实场景,包含网线插接、钥匙开门等14类交互任务和过去只收录完美示范动作的数据集不同,这版开源内容加入大量失败操作、环境干扰等真实样本,还原物理世界的不确定性。
这也意味着,具身智能数据的核心竞争力,已经告别单纯拼数量的时代,转向数据质量与场景价值的较量。那些能够覆盖长尾场景、容错场景、真实工况的结构化数据,成为行业硬通货。
但多数AI研发企业普遍面临三重核心痛点,短期内还难以自己解决。
成本高企,重基建玩不起。自研数据成本极高,具身数据需要真机采集、多模态同步、精细标注等全流程工程化操作,数据交易网此前调研发现,EGO/UMI等一小时有效数据的采集治理成本动辄上百元,一小时真机采集成本动辄大几百元甚至上千元,中小AI团队根本无力承担。
开源数据集“不好用”。网上公开数据集场景单一、样本同质化严重,缺少工业精密操作、复杂居家环境、动态干扰等高价值垂类样本,还经常出现元数据缺失、模态不同步、标注混乱等问题,没法直接拿来训练高精度模型。
合规风险如影随形。不少公开数据来源模糊,权属划分不清,缺少完整溯源和脱敏流程。不仅不能支撑商业化,还极易侵犯版权和隐私,难以适配数据资产登记、模型合规审计等行业新要求。
产业竞争的底层逻辑从来都是“谁能补齐短板,谁就能抢占先机”。
面对全行业的具身数据供给困境,亮数据中国区负责人表示,依托多年AI数据集领域的技术和工程积累,企业已经完成技术、流程、资源储备,具备服务各类AI模型训练的数据服务能力,做好了切入具身智能新赛道的准备。
长期以来,亮数据深耕AI训练数据基建。沉淀了面向机器人和物理AI应用的大规模多模态数据集,这些经过整理的数据集包含超过40亿条结构化记录,涵盖视频流、音频记录、传感器读数、运动数据和环境背景信息。
同时,在AI与LLM专属数据集产品线中,亮数据目前提供215套以上数据集,总记录数超过170亿条,覆盖图像、视频、文本、语音等类别,可用于大模型预训练、指令微调等场景。
公司创始之初,亮数据搭建了全流程标准化的数据生产与质检体系,建立了从数据采集、筛选、清洗、结构处理、脱敏到审计溯源的全链路闭环机制。数据管道符合GDPR和CCPA标准,并遵循ISO 27001、SOC 2、SOC 3和CSA STAR等行业安全标准。
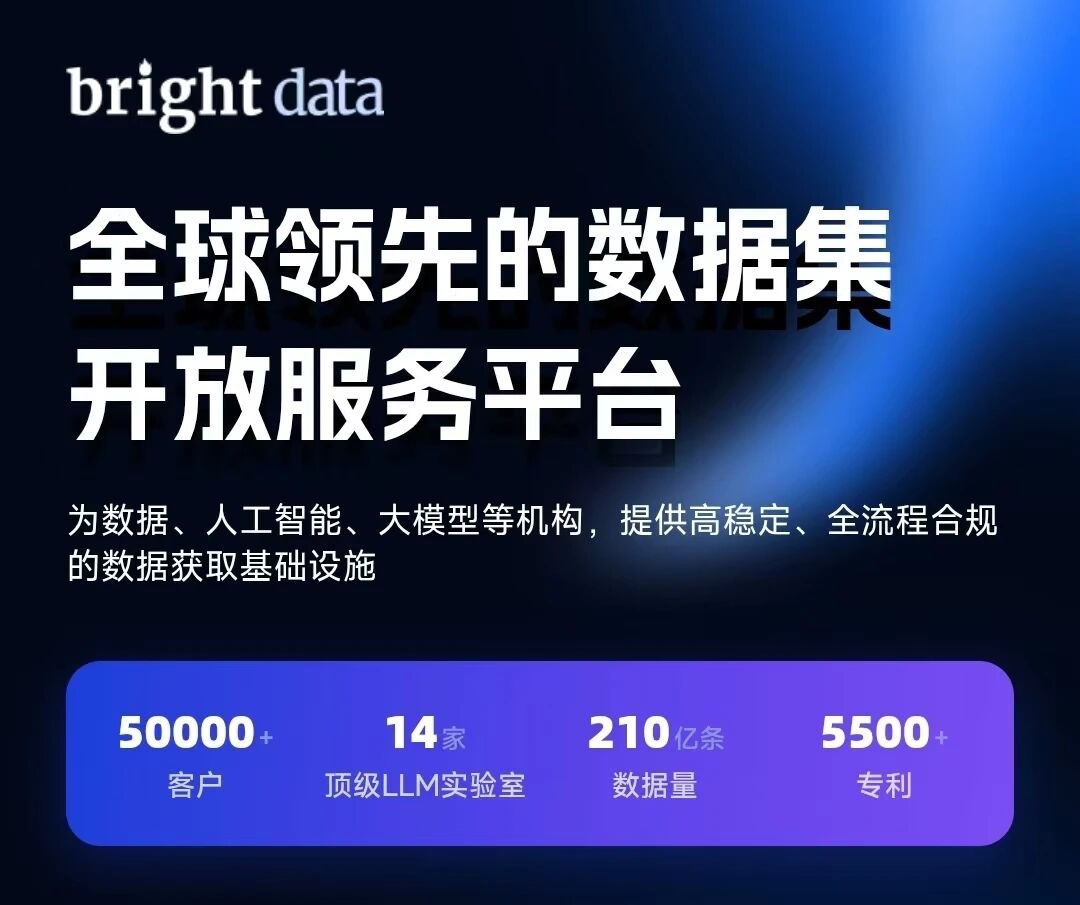
目前亮数据已为全球超过5万家客户提供数据服务,其中包括14家全球头部AI实验室中的多家。
据透露,亮数据已经把具身智能、物理AI相关数据定为下一阶段核心战略方向,为物理AI产业落地赋能。
未来公司将重点深耕真实物理场景数据建设,针对性打造细粒度、专业化的具身多模态数据产品。区别市面上的通用数据集,产品会大量纳入真实工况下的环境干扰、操作失误轨迹、人工修正流程、长尾异常案例,解决现有数据脱离现实、容错差、场景局限的痛点,还原真实物理世界的复杂逻辑。
同时针对VLA视觉-语言-行动模型、世界模型、机器人强化学习训练的专属需求,强化多模态时序对齐、动作细粒度标注、场景特征提取、无效样本智能剔除等能力,做到交付的数据开箱即用,企业不用二次加工,直接提升模型训练效率与落地效果。
AI产业的上半场,算力是核心壁垒,企业比拼硬件储备与算力调度能力,迈入具身智能主导的物理AI下半场,高质量、场景化、合规化的数据底座,才是真正的护城河。
硬件可以快速迭代,算法可以持续优化,但AI对真实物理世界的感知、理解与适配能力,只能靠源源不断的真实物理交互数据慢慢打磨。
属于具身智能的数据竞速赛,已经进入白热化。
行业已经形成共识:未来,那些可以持续输出完备具身智能数据产品体系的企业,会迎来发展红利。补齐物理AI的数据短板,依托数据基建打破模型落地桎梏,将成为行业参与者共同的使命。



评论 0